


EF 4.0 et BAFU : vers un socle commun pour les données d’ACV ?
Naeem Adibi & Emilie Guilvert
Des données plus accessibles. Une transparence accrue. Un socle commun pour éclairer les décisions environnementales. L’ambition portée par la future base de données européenne Environmental Footprint reste particulièrement prometteuse. Le webinaire organisé par la Commission européenne le 22 septembre 2026 a permis de préciser cette ambition, tout en mettant en lumière les choix qui détermineront sa capacité à tenir ses promesses.
Dans notre précédent article consacré à EF 4.0, nous avons analysé comment une base de données gratuite et lisible par machine pourrait transformer l’Analyse du Cycle de Vie (ACV). Les dernières présentations et discussions apportent des éléments importants : le calendrier de développement évolue, les modalités d’accès restent à définir et la coopération avec les bases de données existantes se concrétise progressivement.
Pour les entreprises, l’opportunité est considérable : disposer de données environnementales plus faciles d’accès, plus simples à comprendre et plus aisément intégrables dans les processus de décision. Pour concrétiser cette ambition, il sera toutefois indispensable de disposer de règles claires, de modèles fiables et d’investir durablement dans la qualité des données.
Quand la nouvelle base de données EF sera-t-elle disponible ?
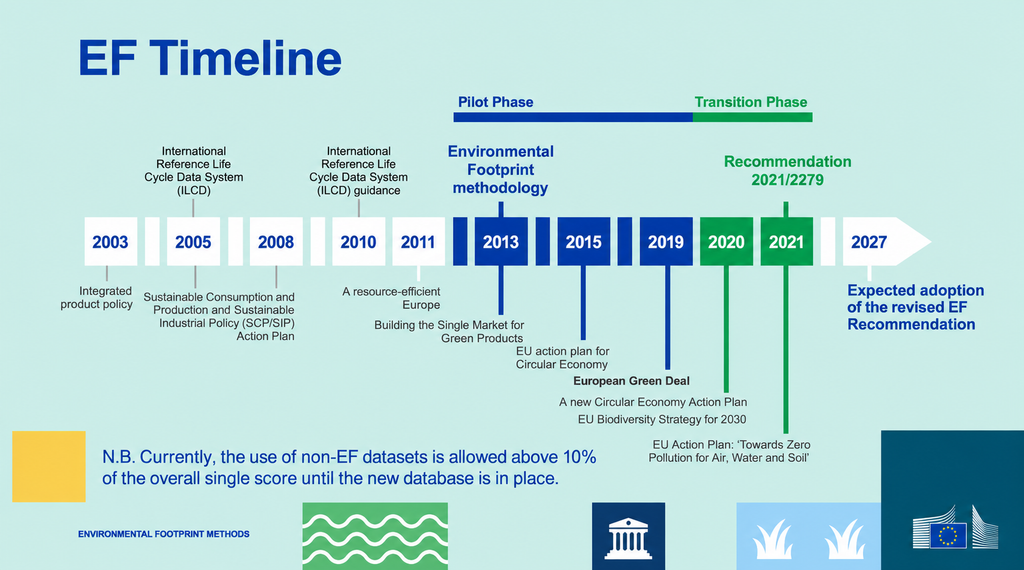
Le webinaire prévoit la publication de la recommandation EF révisée en 2027. La méthode et la base de données qui l’accompagne suivent des calendriers distincts : il s’agit d’une évolution importante par rapport aux perspectives présentées dans notre précédent article.
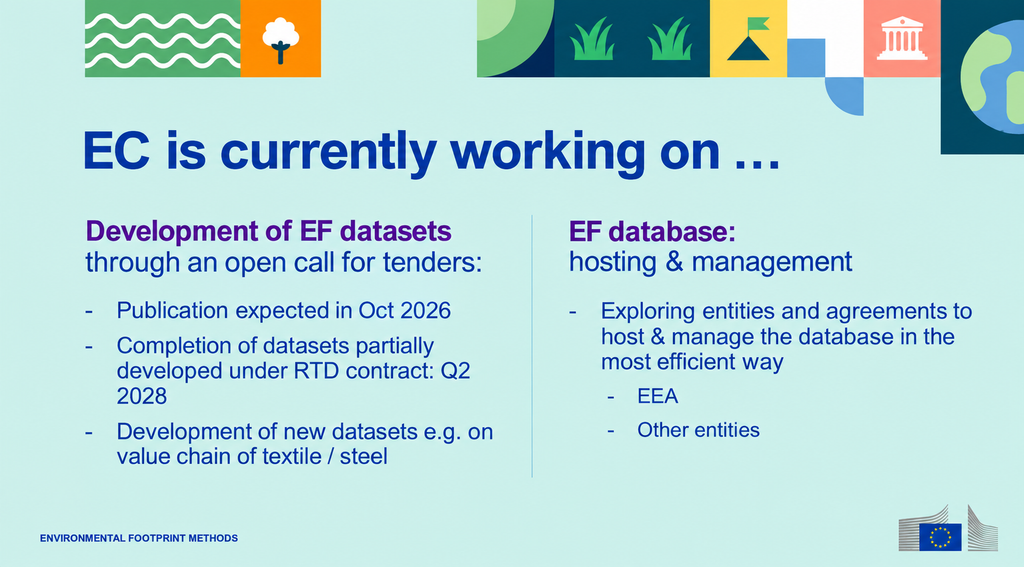
La Commission prévoit de publier plusieurs appels d’offres en Octobre 2026. Celui-ci aura pour objectif d’achever les jeux de données partiellement développés dans le cadre d’un précédent contrat de la DG Recherche et Innovation, qui, selon les explications de la Commission, avait pris fin prématurément pour des raisons administratives, ainsi que de développer de nouveaux jeux de données.
La Commission vise le deuxième trimestre 2028 pour finaliser les jeux de données dont le développement avait déjà commencé. Lors des échanges, elle a également indiqué prévoir que les jeux de données couverts par le prochain appel d’offres, y compris les nouveaux, soient finalisés d’ici mi-2028. Les principaux domaines concernés comprennent l’énergie, le transport, les emballages, les procédés de fin de vie, les produits chimiques et les métaux ; le textile et l’acier figurent notamment parmi les exemples de secteurs pour lesquels des développements supplémentaires ont été évoqués.
Les solutions d’hébergement, la gestion de la base de données et la plateforme informatique sont étudiées parallèlement à ces travaux. Ces échéances doivent donc être considérées comme des objectifs de développement, et non comme la date garantie de lancement d’une base de données pleinement opérationnelle couvrant l’ensemble des secteurs.
Les données d’EF 4.0 seront-elles librement accessibles et réutilisables ?
Une précision apportée oralement mérite une attention particulière. La Commission a indiqué que son objectif était de garantir un accès libre. Toutefois, les modalités définitives d’accès et de licence n’ont pas été établies lors de l’atelier.
Cette précision vient nuancer la perspective d’une base de données entièrement gratuite évoquée dans notre précédent article. Le caractère abordable et l’accessibilité des données constituent clairement des priorités, notamment pour les entreprises qui utilisent des données environnementales afin de démontrer leur conformité.
Pour les développeurs de logiciels et les entreprises qui conçoivent des configurateurs de produits, les questions pratiques concernent également la réutilisation des données : quelles données pourront être intégrées dans un outil, adaptées, partagées avec les clients ou maintenues dans le temps ? Des réponses claires seront indispensables pour favoriser les investissements dans les services numériques dédiés à l’ACV.
Quel rôle BAFU peut-il jouer pendant la transition et au-delà ?
La base de données BAFU de l’Office fédéral de l’environnement suisse a été présentée comme un exemple opérationnel d’infrastructure ouverte de données d’inventaire du cycle de vie. BAFU a indiqué que sa base comptait 11 747 inventaires, principalement axés sur le contexte suisse, avec des possibilités d’élargir sa couverture grâce à la coopération internationale.
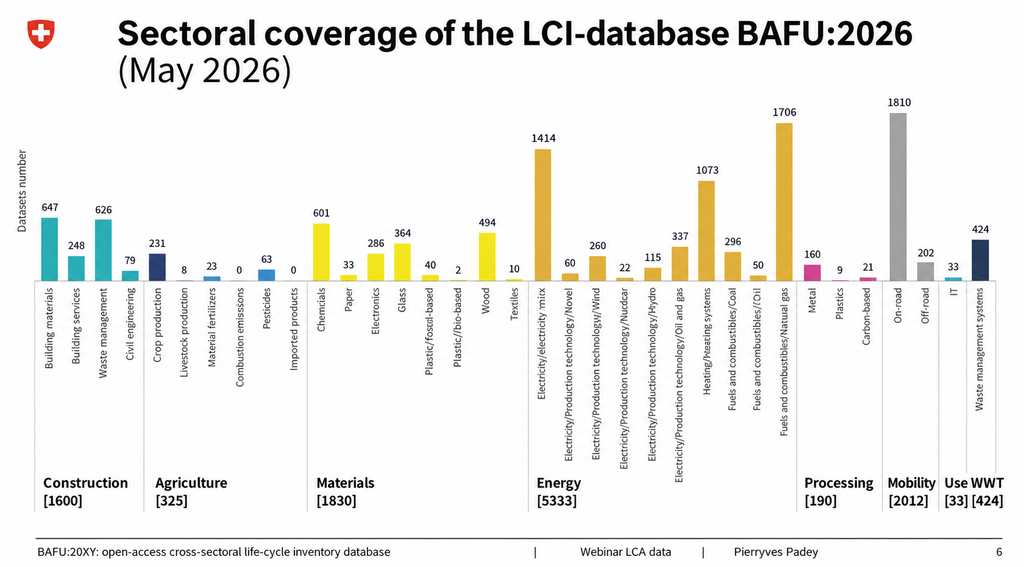
Les échanges ont permis d’établir un lien direct avec EF. La Commission a explicitement identifié BAFU comme une base de données qui, selon son évaluation, répond aux exigences des lignes directrices provisoires pour l’application des méthodes EF tant que la nouvelle base de données EF n’est pas disponible. Elle a également confirmé que, durant cette période, les praticiens restent libres de choisir leur base de données : BAFU constitue donc une option, et non un choix obligatoire.
Cela ne signifie pas pour autant que chaque jeu de données de BAFU est automatiquement adapté à tous les produits ou à toutes les zones géographiques. La représentativité, les choix de modélisation et la cohérence des données doivent toujours être évalués. La Commission a également exprimé son intérêt pour une future coopération avec BAFU. Parallèlement, le Partnership for Life Cycle Data a présenté la base de données ProBas visant à adapter plusieurs milliers de jeux de données suisses au contexte allemand et à développer de nouveaux jeux de données spécifiques à l’Allemagne au cours des trois prochaines années.
La mise en place d’un socle commun de données devient une possibilité concrète. Sa valeur dépendra toutefois du soin apporté à l’adaptation et à l’interconnexion des données.
Comment concilier transparence et confidentialité industrielle ?
Les arguments en faveur d’une plus grande transparence ont occupé une place importante tout au long de l’atelier. Les praticiens doivent pouvoir comprendre les hypothèses qui sous-tendent un résultat, examiner les processus d’arrière-plan et déterminer si un jeu de données est adapté à leur étude.
Les échanges ont également montré à quel point la manière dont cette transparence est mise en œuvre est déterminante. Des données industrielles détaillées peuvent révéler des informations commercialement sensibles, notamment certains éléments relatifs aux coûts de production. Les participants ont exprimé différents points de vue quant au niveau de divulgation publique souhaitable et aux moyens de préserver la confidentialité.
Plusieurs approches ont été évoquées : l’utilisation de moyennes représentatives établies à partir des données de plusieurs producteurs, un accès plus complet pour les vérificateurs indépendants, ainsi qu’une visibilité suffisante sur les règles de modélisation afin de permettre leur examen et la réalisation de modélisations spécifiques aux entreprises. Aucune de ces approches n’a toutefois été retenue comme solution définitive pour EF.
Pour WeLOOP, l’enjeu pratique est de permettre aux utilisateurs de comprendre le modèle et aux vérificateurs d’accéder aux éléments nécessaires pour en évaluer la fiabilité. L’architecture devra clairement définir ces différents niveaux de responsabilité.
Comment transformer les données industrielles en jeux de données ACV fiables ?
Un échange particulièrement intéressant a porté sur la manière dont les entreprises devraient contribuer. Doivent-elles fournir des données brutes ou des jeux de données ACV complets et vérifiés ?
La transmission de données brutes pourrait faciliter la participation des entreprises ne disposant pas de compétences spécialisées en modélisation. Un accompagnement par des experts pourrait ensuite permettre de transformer ces données en inventaires cohérents. D’autres participants ont toutefois souligné que la création de jeux de données nécessite un dialogue avec les industriels concernant la représentativité, les frontières des processus, les règles d’allocation et les choix de modélisation.
Une plateforme de soumission ou un outil d’édition des jeux de données pourrait faciliter ce travail. À lui seul, un tel outil ne peut toutefois pas résoudre les questions méthodologiques qui sous-tendent les données.
Le même principe s’applique à l’intelligence artificielle. La Commission a invité les participants à proposer des pistes pour utiliser l’IA afin de simplifier la soumission et la revue des données ainsi que la gestion de la base de données. Ces possibilités restent à explorer, en plaçant la traçabilité des données, leur qualité et la responsabilité au cœur de leur mise en œuvre.
Que faudra-t-il mettre en place pour garantir la qualité des données et une vérification indépendante ?
L’un des messages les plus marquants des échanges concernait la nécessité d’une vérification indépendante. Développer davantage de jeux de données n’apportera qu’une valeur limitée si leur fiabilité n’est pas suffisamment contrôlée.
Les participants ont souligné la nécessité de faire appel à des vérificateurs combinant une expertise en ACV et une connaissance des procédés industriels concernés. Ils ont également rappelé qu’une notation de la qualité des données ne saurait se substituer à un examen approfondi de leur représentativité et des hypothèses de modélisation.
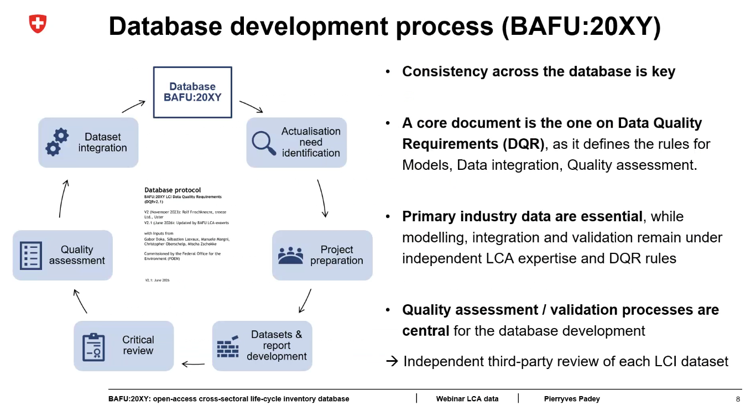
La présentation de BAFU a fourni un exemple concret de gouvernance : les autorités publiques définissent le cadre ; les industriels fournissent les données primaires et leur expertise technique ; les experts en ACV élaborent des modèles cohérents ; et des vérificateurs indépendants évaluent les travaux réalisés. BAFU publie ses rapports de vérification accompagnés de la documentation correspondante. La crédibilité exige d’investir autant dans la vérification que dans la production des données.
Comment assurer la cohérence entre les données, les méthodes et les initiatives internationales ?
Les participants ont soulevé un autre défi : développer des jeux de données alors que des révisions méthodologiques sont encore en cours de discussion. Le carbone biogénique constitue notamment un exemple pour lequel la cohérence entre les conventions de comptabilisation et les modèles utilisés dans les bases de données est essentielle. Les travaux de normalisation menés à l’échelle internationale renforcent également la nécessité de coordonner soigneusement les décisions.
La maintenance des bases de données soulève une problématique similaire. Celles-ci doivent refléter les évolutions technologiques, tandis que les applications liées aux politiques publiques nécessitent une stabilité suffisante pour permettre aux entreprises d’interpréter les seuils et de suivre leurs progrès. Des versions clairement identifiées, des mises à jour documentées et des calculs reproductibles seront donc essentiels.
Les contributeurs ont également appelé à renforcer les liens avec les initiatives nationales et le Global LCA Atlas. La Commission a reconnu l’importance d’éviter la duplication des efforts, tout en soulignant que sa responsabilité immédiate était de soutenir la mise en œuvre des politiques européennes.
Comment les entreprises peuvent-elles se préparer à la prochaine génération de données ACV ?
Les entreprises peuvent se préparer en documentant les jeux de données et leurs versions utilisés dans leurs études actuelles, en renforçant la collecte de données primaires et en identifiant les hypothèses relatives aux données d’arrière-plan qui influencent significativement les résultats. Les outils numériques devront ensuite être capables d’intégrer les mises à jour des bases de données tout en préservant la traçabilité des calculs antérieurs.
Les entreprises pourront également répondre à l’appel d’offres prévu en octobre 2026 afin de finaliser les jeux de données partiellement développés et d’en créer de nouveaux, notamment pour les secteurs de l’acier ou du textile.
Chez WeLOOP, nous voyons dans l’amélioration de l’accessibilité des données une réelle opportunité d’élargir le recours à l’ACV et d’accélérer l’éco-conception.
EF 4.0 gagnera la confiance des utilisateurs grâce aux décisions que ses données permettront d’éclairer. Les travaux nécessaires pour construire cette confiance prennent désormais forme.
De la recherche aux données ACV partagées : quelle est la contribution de WeLOOP ?
Chez WeLOOP, nous contribuons activement au développement de données d’inventaire du cycle de vie (ICV) à travers des projets de recherche et des collaborations avec les industriels. Notre participation à des projets financés par l’Union européenne, notamment BIOARC, Bio4HUMAN, CALIMERO, CEDaCI, AQUALICIOUS et MOXY, contribue à la collecte de données et à la modélisation environnementale dans des secteurs allant des matériaux biosourcés et de l’aquaculture aux équipements numériques et à la conservation du patrimoine culturel. Nous considérons les projets de recherche européens comme une source riche de données primaires susceptibles de contribuer à enrichir la future base de données EF 4.0, sous réserve d’un alignement méthodologique, d’une vérification indépendante et de droits de réutilisation appropriés.
Dans le secteur des batteries, notre base de données BATTERS fournit des inventaires détaillés des procédés de recyclage et des matériaux recyclés, complétés par des travaux en cours sur les inventaires de fabrication des cellules de batteries. Nous contribuons également au développement de données environnementales pour les équipements électriques et électroniques à travers le projet naKnow, soutenu par le programme ECONUM de France 2030, piloté par l’ADEME, en combinant caractérisation des composants, données expérimentales issues de laboratoire et modélisation. Notre ambition est de transformer les connaissances acquises dans le cadre de ces projets en données fiables et réutilisables, capables de renforcer le socle commun sur lequel repose l’ACV.